AI Native Infrastructure
公司级 AI Native 基础设施
让每个人手上的 AI 助手都用上同一份公司知识——而不是让每个团队各自造一个 AI 应用。它不新增一个系统,只把公司已有的知识、工具和使用边界,变成 AI 随时能取用的东西。
公司里想用 AI 的人很多,但每个场景各建一套服务,结果是重复建设、知识散落、越用越乱。这个项目换了个问法:同事每天已经在用自己的 AI 助手干活了,为什么还要再给他们一个应用?于是它不做 AI 应用,只做更底层的准备——把公司知识、能用的工具和使用边界整理清楚,让每个人手里的助手直接取用。
我做的事
- 把接入做成三个不用动脑的动作:填名字 → 复制 → 粘给 AI。任何需要额外理解、额外决策的步骤,都算没做好。
- 让一次配置变成值得展示的身份:成员自助接入、个人凭证,加上一块 3D 电子工牌的颁发仪式——把技术动作翻译成组织里看得见的东西,公司约 90% 的同事完成了接入。
- 知识只留一个真相源:一份 Markdown 文档,谁都能改、每次改动留痕。暂时不上向量库,等文档规模真的到瓶颈再说——少一层基础设施,就少一份长期维护。
- 把边界写进设计里,而不是写进规范里:凭证只签发一次、不留明文;成员只能写指定目录;AI 想改知识,先把草稿给人看,确认后才落库。
- 碰业务数据时守三条线:按需取用、不曲解语义(空、无、零是三种不同的事实)、隐私字段先脱敏。
- 核心知识文档与业务能力每周累计调用 300+ 次。接入说明本身也有测试兜底——改一句话测试就会失败,因为「能不能顺利接进来」是产品底线,不是文档问题。
架构
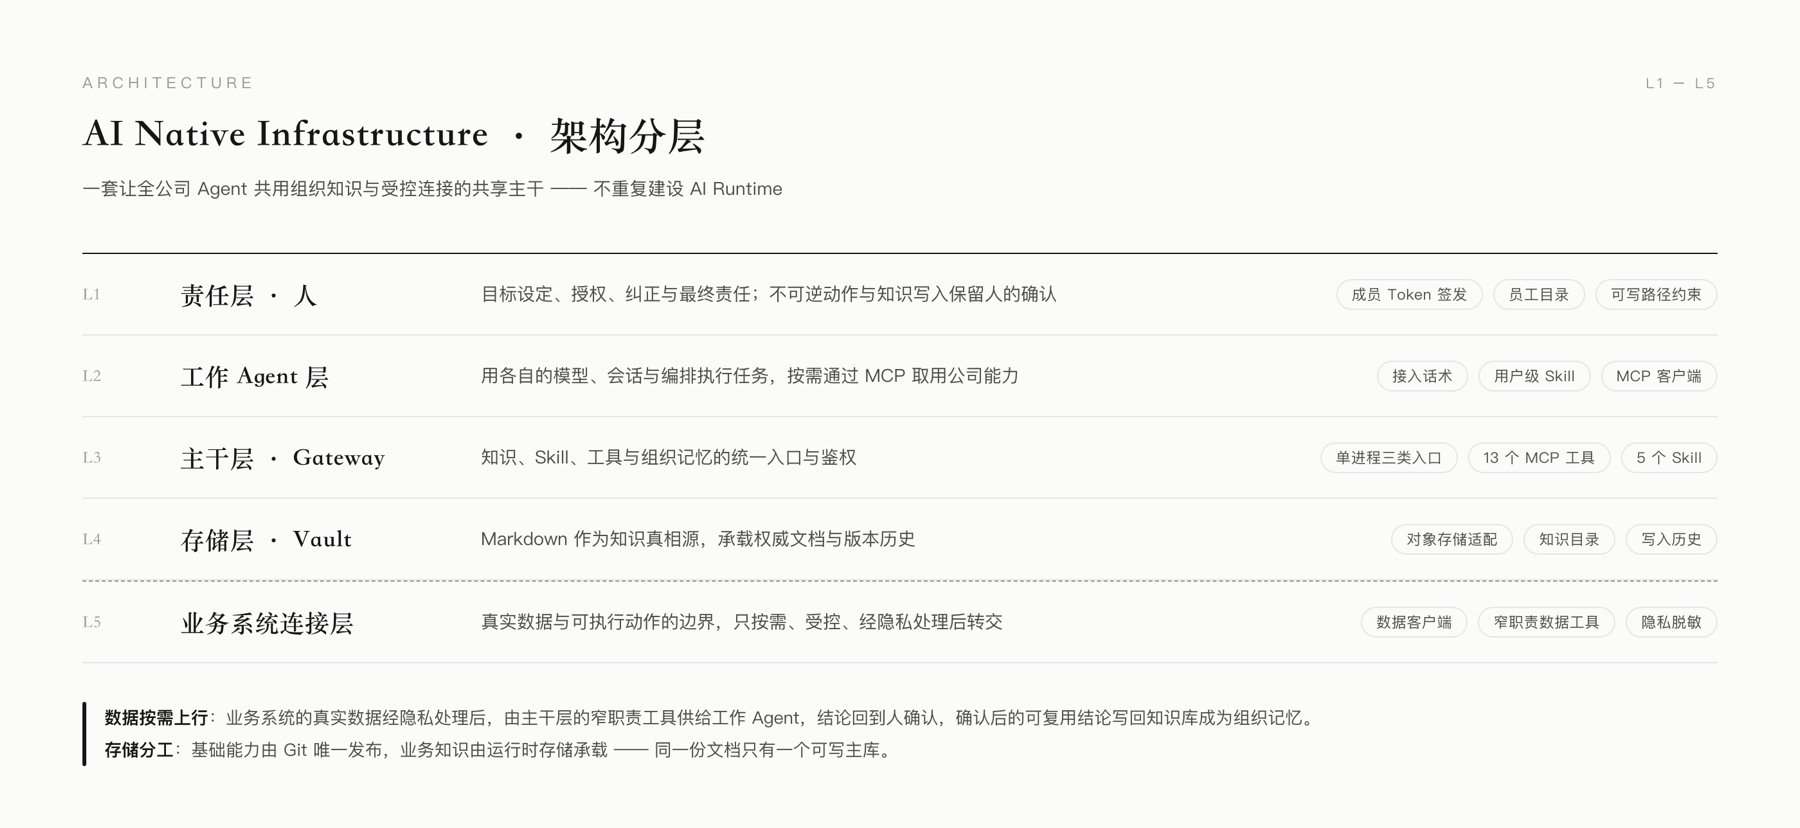
几个设计判断
- 复杂留给系统,简单留给同事:能靠服务端和页面消化的复杂度,不转移到使用者身上。
- 先想清楚「谁来负责」:不可逆的动作和知识写入,永远保留人的确认环节。
- 不重复造轮子,包括不重复造 AI:模型、会话、编排交给每个人自己的助手,这里只做真正共享的部分。
- 宁可少一层,也不要多一份长期维护:每新增一个组件,都要先回答它能不能被别的方式替代。
项目涉及公司内部系统,这里只展示架构与设计判断,不包含产品界面、内部名称、域名与任何内部数据。